


DataFrame
880 字
4 分钟
DataFrame

DataFrame学习
DataFrame基本介绍
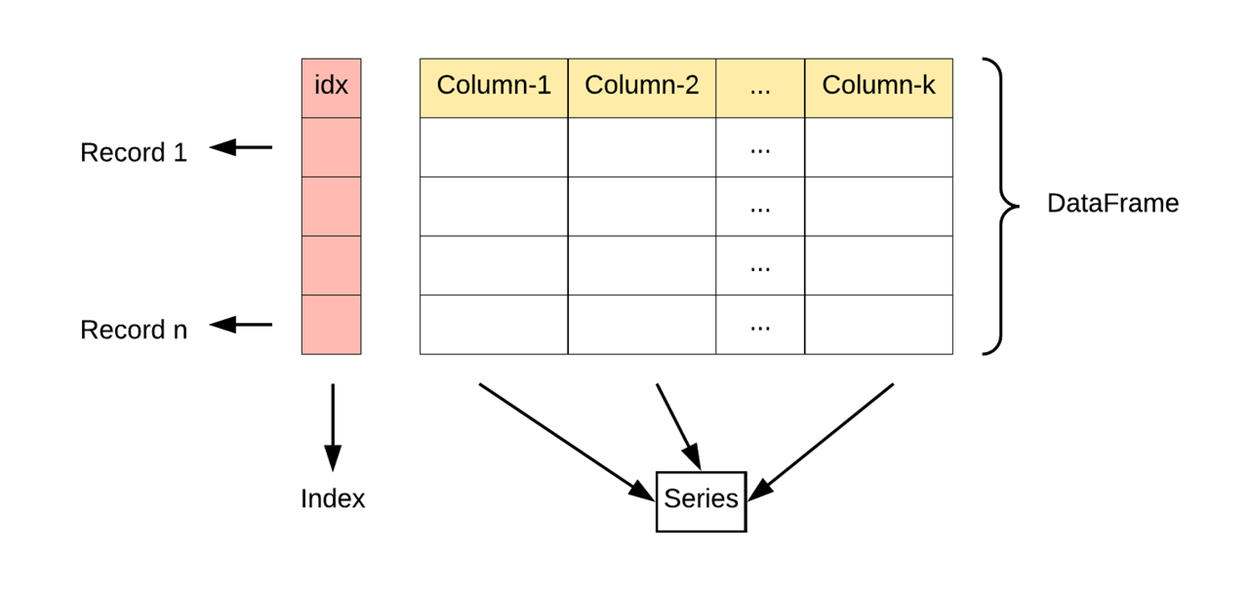 在 pandas 中,DataFrame 是一种二维表格型数据结构,可以理解为 “带标签的二维数组” 或 “多个 Series 的组合”。它具有行索引(index)和列索引(columns),能够存储不同数据类型的列(如整数、字符串、日期等),是 pandas 中最核心、最常用的数据结构,广泛用于数据分析、清洗和处理。
如果把 Series 比作 “带标签的一列数据”,那么 DataFrame 就是 “带标签的多列数据组成的表格”。例如:
| 姓名 | 年龄 | 城市 |
|---|---|---|
| 张三 | 25 | 北京 |
| 李四 | 30 | 上海 |
| 王五 | 28 | 广州 |
这就是一个简单的 DataFrame,其中 “姓名"" 年龄 ""城市” 是列索引,每行的索引默认为 0、1、2(也可自定义)。
DataFrame的创建
# dataframe的创建方式import pandas as pdimport numpy as np# 通过series来创建s1 = pd.Series([1,2,3,4,5])s2 = pd.Series([6,7,8,9,10])df = pd.DataFrame({"第1列":s1,"第2列":s2})# 通过字典来创建df = pd.DataFrame( { "name":["tom",'jack','alice','bob','allen'], "age":[15,17,20,26,30], "score":[60.5,80,30.6,70,83.5] },index=[1,2,3,4,5],columns=["name","score","age"])df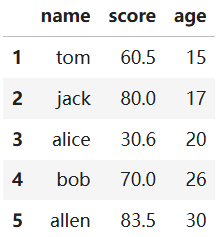
DataFrame的属性
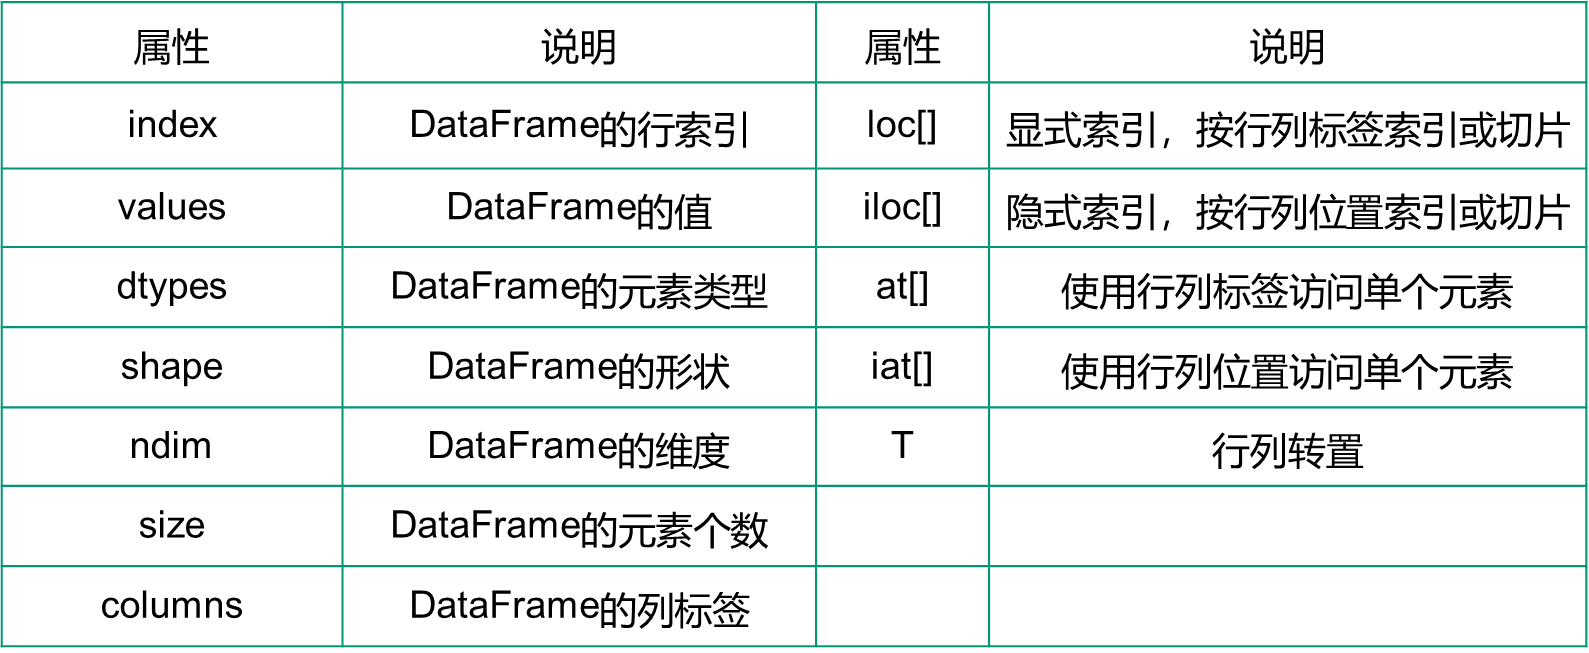
DataFrame的常用方法
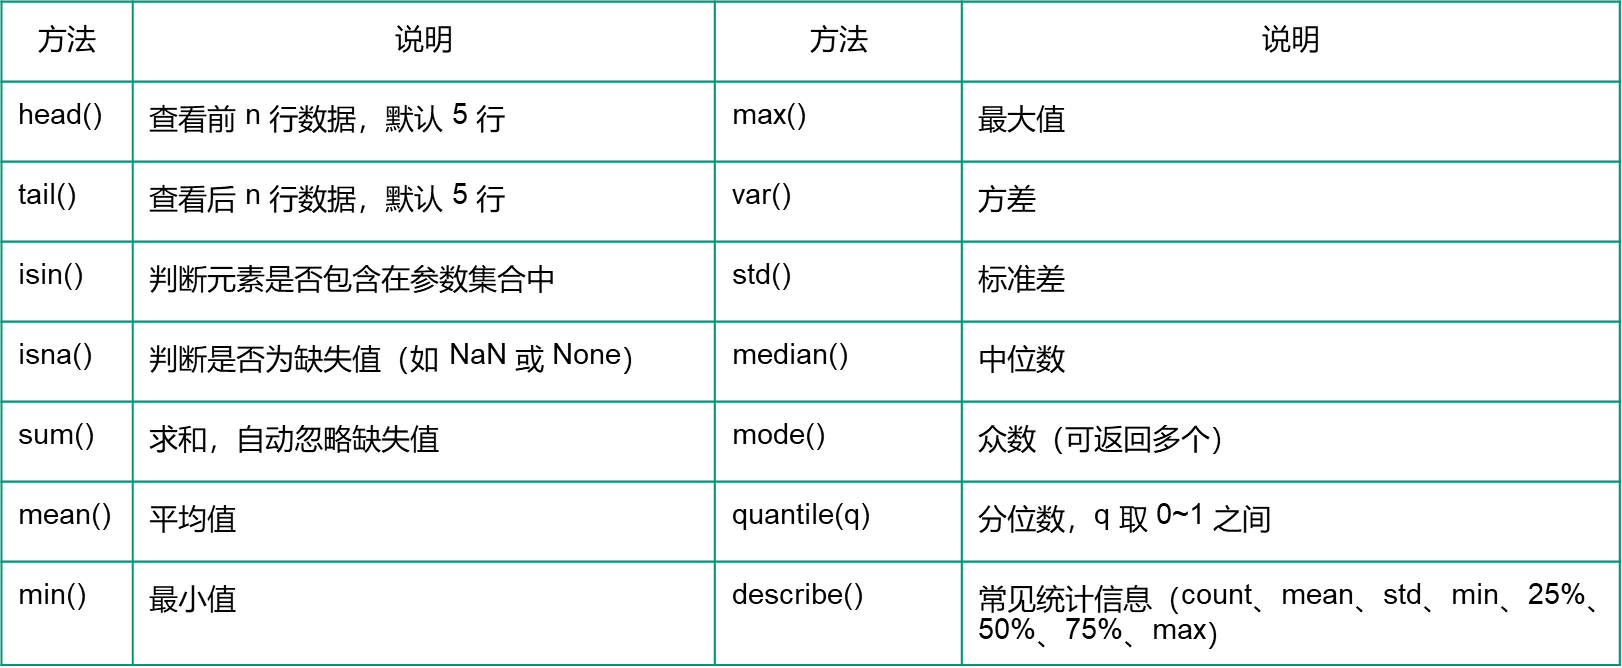
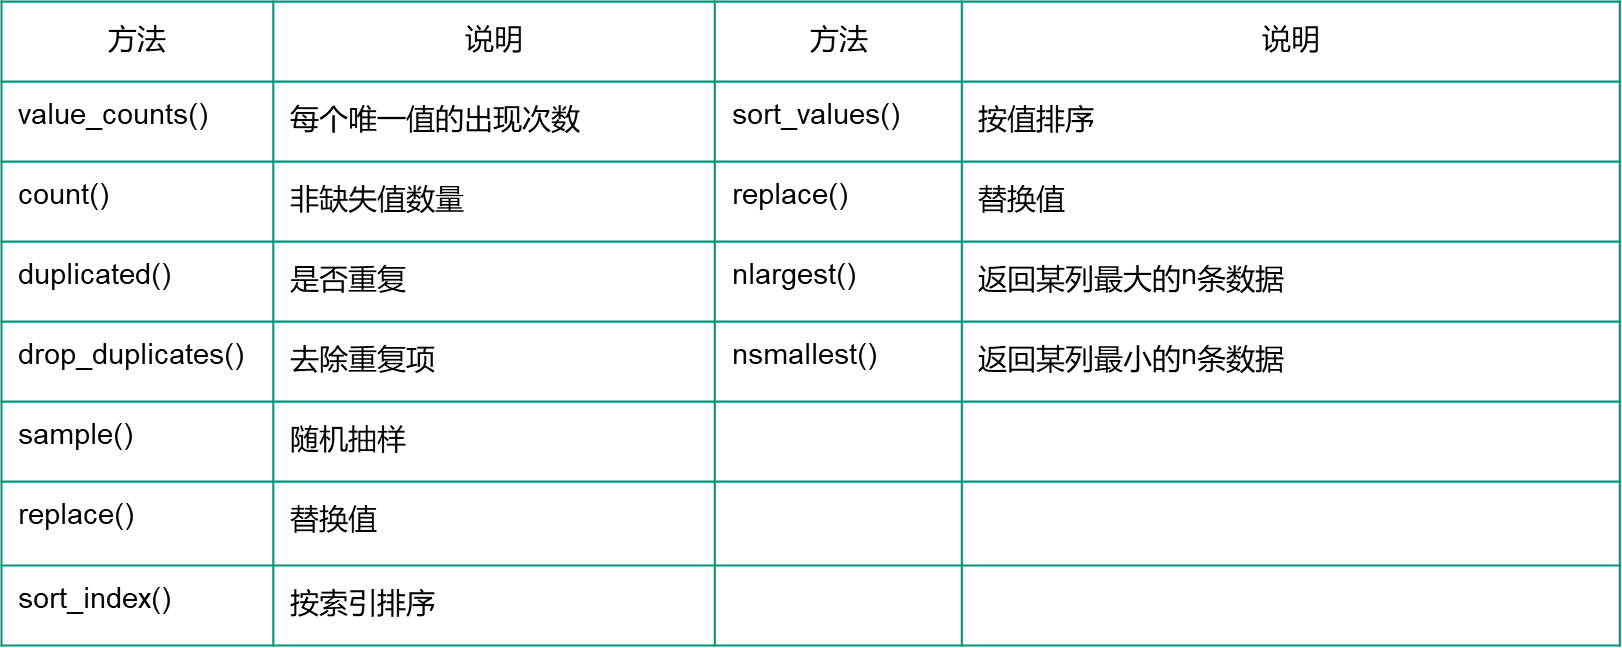
'''案例1:学生成绩分析场景:某班级的学生成绩数据如下,请完成以下任务:1. 计算每位学生的总分和平均分。2. 找出数学成绩高于90分或英语成绩高于85分的学生。3. 按总分从高到低排序,并输出前3名学生。'''import pandas as pddata = { '姓名': ['张三', '李四', '王五', '赵六', '钱七'], '数学': [85, 92, 78, 88, 95], '英语': [90, 88, 85, 92, 80], '物理': [75, 80, 88, 85, 90]}scores = pd.DataFrame(data)
#1. 计算每位学生的总分和平均分。scores['总分'] = scores[['数学','英语','物理']].sum(axis=1)scores['平均分'] = scores['总分'] / 3scores['平均分2'] = scores[['数学','英语','物理']].mean(axis=1)#2. 找出数学成绩高于90分或英语成绩高于85分的学生。scores[ (scores['数学']>90 ) | (scores['英语']>85 ) ]#3. 按总分从高到低排序,并输出前3名学生。r1 = scores.sort_values('总分',ascending=False).head(3)r2 =scores.nlargest(3,columns=['总分'])print(r1)print(r2)'''案例2:销售数据分析场景:某公司销售数据如下,请完成以下任务:1. 计算每种产品的总销售额(销售额 = 单价 × 销量)。2. 找出销售额最高的产品。3. 按销售额从高到低排序,并输出所有产品信息。'''import pandas as pd
data = { '产品名称': ['A', 'B', 'C', 'D'], '单价': [100, 150, 200, 120], '销量': [50, 30, 20, 40]}df = pd.DataFrame(data)df['总销售额'] = df['单价']*df['销量']df.nlargest(1,columns=['总销售额'])df.sort_values('总销售额',ascending=False)'''案例3:电商用户行为分析场景:某电商平台的用户行为数据如下,请完成以下任务:1. 计算每位用户的总消费金额(消费金额 = 商品单价 × 购买数量)2. 找出消费金额最高的用户,并输出其所有信息3. 计算所有用户的平均消费金额(保留2位小数)4. 统计电子产品的总购买数量'''import pandas as pd
data = { '用户ID': [101, 102, 103, 104, 105], '用户名': ['Alice', 'Bob', 'Charlie', 'David', 'Eve'], '商品类别': ['电子产品', '服饰', '电子产品', '家居', '服饰'], '商品单价': [1200, 300, 800, 150, 200], '购买数量': [1, 3, 2, 5, 4]}df = pd.DataFrame(data)df['总消费金额'] = df['商品单价']*df['购买数量']df.nlargest(1,columns=['总消费金额'])df['总消费金额'].mean()df[df['商品类别']=='电子产品']['购买数量'].sum()文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
相关文章智能推荐
1
pandas 缺失值处理
数据分析记录 pandas 中缺失值检查、删除、填充和简单统计的常用写法。
2
pandas 分析报告流程
数据分析整理从原始数据到 pandas 分析报告的完整流程,强调可复查和可交付。
3
pandas 缺失值填充策略
数据分析整理 pandas 缺失值填充策略,以及不同字段为什么不能使用同一种填法。
4
pandas 交叉表统计
数据分析记录 pandas crosstab 交叉表的用法,用于分析两个分类变量之间的关系。
5
pandas rolling 滑动窗口
数据分析整理 pandas rolling 滑动窗口的基本用法,以及时间序列分析中的注意事项。
随机文章随机推荐
欢迎来到TengJinCheng工作铺!
音乐
暂未播放
0:000:00
文章
157
分类
7
标签
114
总字数
109,939
运行时长
0 天
最后活动
0 天前
站点域名blog.tjcheng.cn
Fireflyv6.13.4
Astrov7.0.2
Nodev22.23.1
pnpmv9.14.4
构建时间2026年7月10日 11:01:37
系统信息Linux / x86_64